字母圈测试数据统计
这些数字来自用户主动点击「匿名贡献」的结果聚合。 服务器只知道「某个结果出现了多少次」——不含任何答案、IP 或身份信息。
如果你想知道的是「字母圈在人群中的比例」—— 这些数据回答不了那个问题,我们在下方写清了原因。
属性测试(10题)
58 份深度属性测试(25题)
65 份SM 偏好测试(8题)
60 份Brat 偏好测试(6题)
21 份K0-K9 分级测试(8题)
104 份完整统计表
列出所有测试的全部结果(含暂无数据的项)。下表与上方条形图同源,便于整表引用或导出。
| 测试 | 结果 | 份数 | 占比 |
|---|---|---|---|
| 属性测试(10题) 小计 58 份 | 偏 Dom(主导) | 20 | 34.5% |
| 偏 Sub(顺从) | 23 | 39.7% | |
| Switch(双向) | 15 | 25.9% | |
| 深度属性测试(25题) 小计 65 份 | 偏 Dom(主导) | 11 | 16.9% |
| 偏 Sub(顺从) | 21 | 32.3% | |
| Switch(双向) | 33 | 50.8% | |
| SM 偏好测试(8题) 小计 60 份 | 偏 S(施加) | 15 | 25.0% |
| 偏 M(承受) | 19 | 31.7% | |
| 两侧均衡 | 26 | 43.3% | |
| Brat 偏好测试(6题) 小计 21 份 | 乖巧顺从型 | 2 | 9.5% |
| 潜力 Brat | 6 | 28.6% | |
| 资深 Brat | 3 | 14.3% | |
| 究极 Brat | 10 | 47.6% | |
| K0-K9 分级测试(8题) 小计 104 份 | K1 贴身服侍型 | 9 | 8.7% |
| K2 角色服从型 | 3 | 2.9% | |
| K3 恋痛倾向型 | 7 | 6.7% | |
| K4 束缚绳缚型 | 15 | 14.4% | |
| K7 亲密伴侣型 | 12 | 11.5% | |
| K8 Brat / 小恶魔型 | 37 | 35.6% | |
| K9 犬系驯服型 | 21 | 20.2% | |
| 合计 | 308 | 100% | |
数据来源:seamulab.com 用户主动提交的匿名结果标签计数 · 导出日期 2026-10-02
字母圈在人群中的比例是多少?
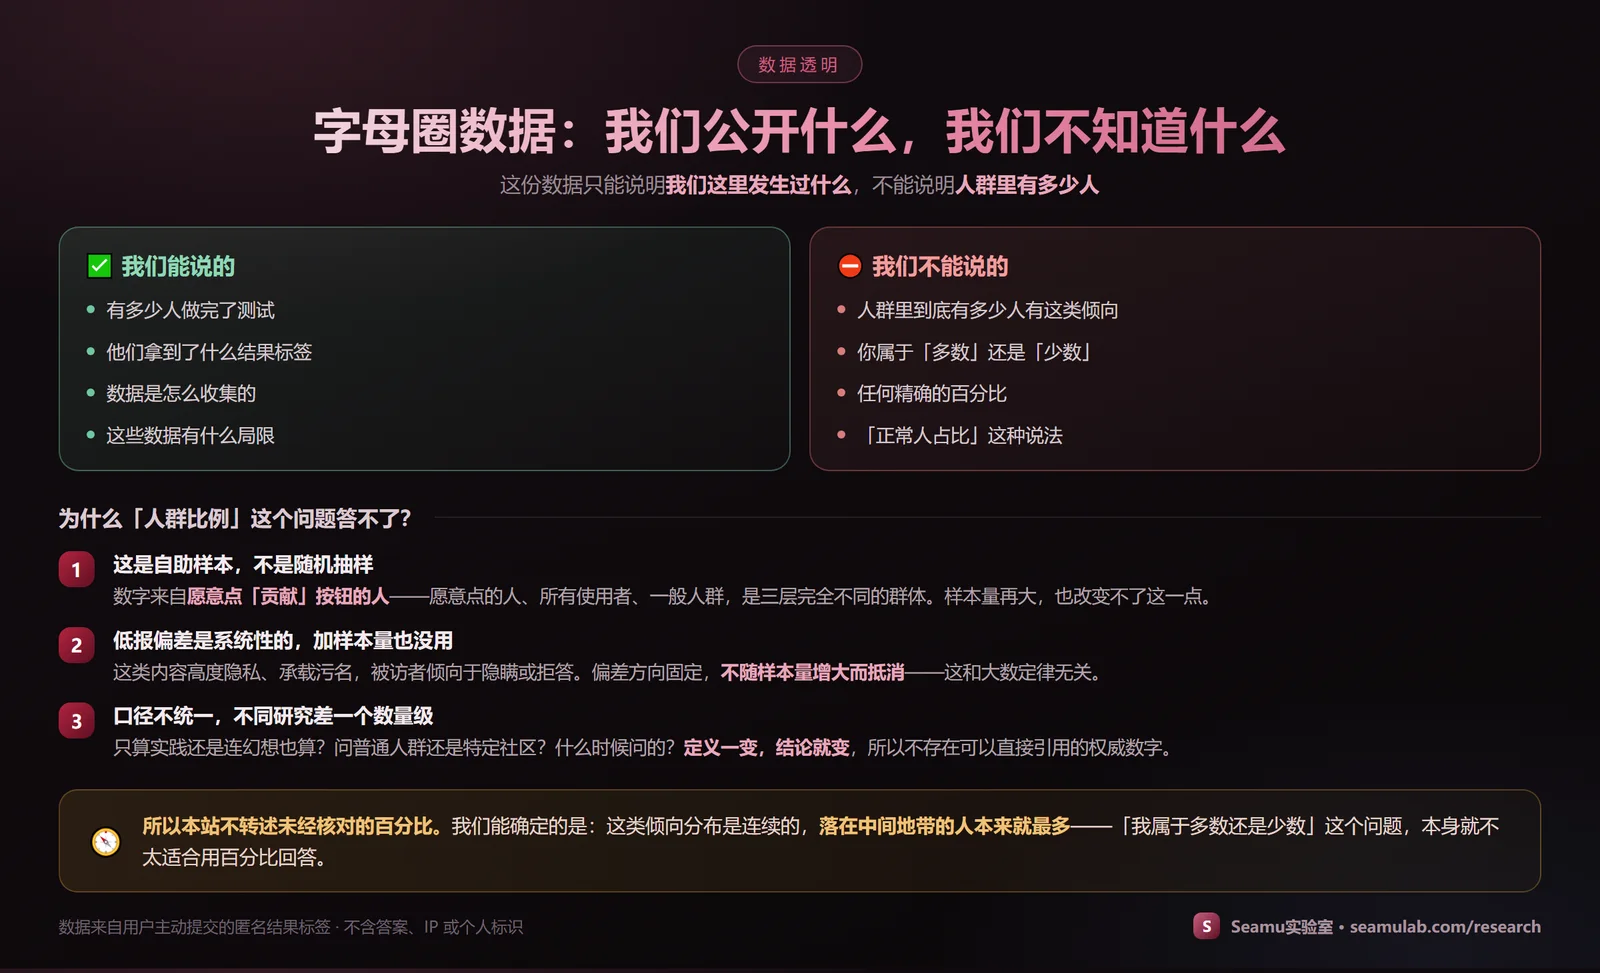
这是这个领域里被搜得最多的一个数据问题。但我们必须先把结论说在前面: 我们答不了,而且目前也没有可靠答案。
① 我们自己的数据答不了
上面那些数字来自愿意点「贡献」按钮的人——这是自助样本。 愿意点的人,和所有使用者不是一回事;使用者又和一般人群不是一回事。 哪怕我们有一百万份,它仍然只说明「在我们这里观察到的情况」。
② 随机抽样调查几乎没有
要回答「人群比例」,需要随机抽样的代表性样本。 但这类内容高度隐私、承载污名,被访者倾向于隐瞒或拒答—— 所以即便做出来,也普遍存在严重的低报偏差, 而且偏差方向是系统性的,没法靠加大样本量修正。
③ 已有研究的数字差别极大
不同调查给出的比例往往相差一个数量级以上,差异主要来自三件事: 怎么定义(只算实践,还是连幻想也算?)、 问的是谁(普通人群还是特定社区)、 什么时候问的(社会容忍度本身在变)。 由于口径不统一,不存在一个可以直接引用的权威数字。 本站不转述未经核对的具体百分比。
那我们能说的是什么?
能说的是:这类倾向分布是连续的,落在中间地带的人本来就最多—— 这在任何一条光谱上都是常态。
换句话说,「我属于多数还是少数」这个问题本身,就不太适合用百分比来回答。 它更关乎你想怎么生活,而不是你站在人群的哪一格。 如果你真正想问的是「我这样正常吗」,可以读 Sub 的心态 与 测试方法与内容标准。
⚠️ 这份数据能说明什么,不能说明什么
能说明的: 在我们这里、在这段时间内,有多少人做完了测试、以及他们拿到了什么结果标签。
不能说明的(请务必读完):
- 这不是人群比例。这是自助样本——愿意点「贡献」按钮的人,和所有使用者不是一回事,更不代表一般人群。
- 不能用来判断「你属于多数还是少数」。倾向是光谱,落在中间地带的人本来就最多,这既不代表「正常」,也不代表「普通」。
- 题目没有经过信效度检验。我们没有用经验证的心理量表,这些结果只是自我探索的参考(见测试方法与内容标准)。
- 数据允许被修正。开发期产生的测试数据会被清理;运营也可能对展示值做过调整。因此这里的数字不宜当作精确的统计结论引用。
- 同一人在不同时期可能测出不同结果,但我们的去重只做到「同一天同一来源计一次」,所以会有重复计数。
如果你要引用这里的数字,请连同上面这段限制一起引用。
为什么做这一页
市面上的测试都在给结论,很少有人说清自己的数据是怎么来的、边界在哪。 我们更愿意把方法、样本来源和局限一起摆出来——一份允许「暂时没有答案」的数据,比一份看起来很确定的结论更可信。