字母圈测试样本观察:308 份数据能说什么?不能说什么?
我们把站内 308 份匿名测试样本完整公开:五个测试的结果分布、每个百分比的 95% 置信区间,以及三个我们回答不了的问题。这不是字母圈人群的比例,而是主动参与者的自选择样本——本文的重点正是说清「能说什么?不能说什么」。
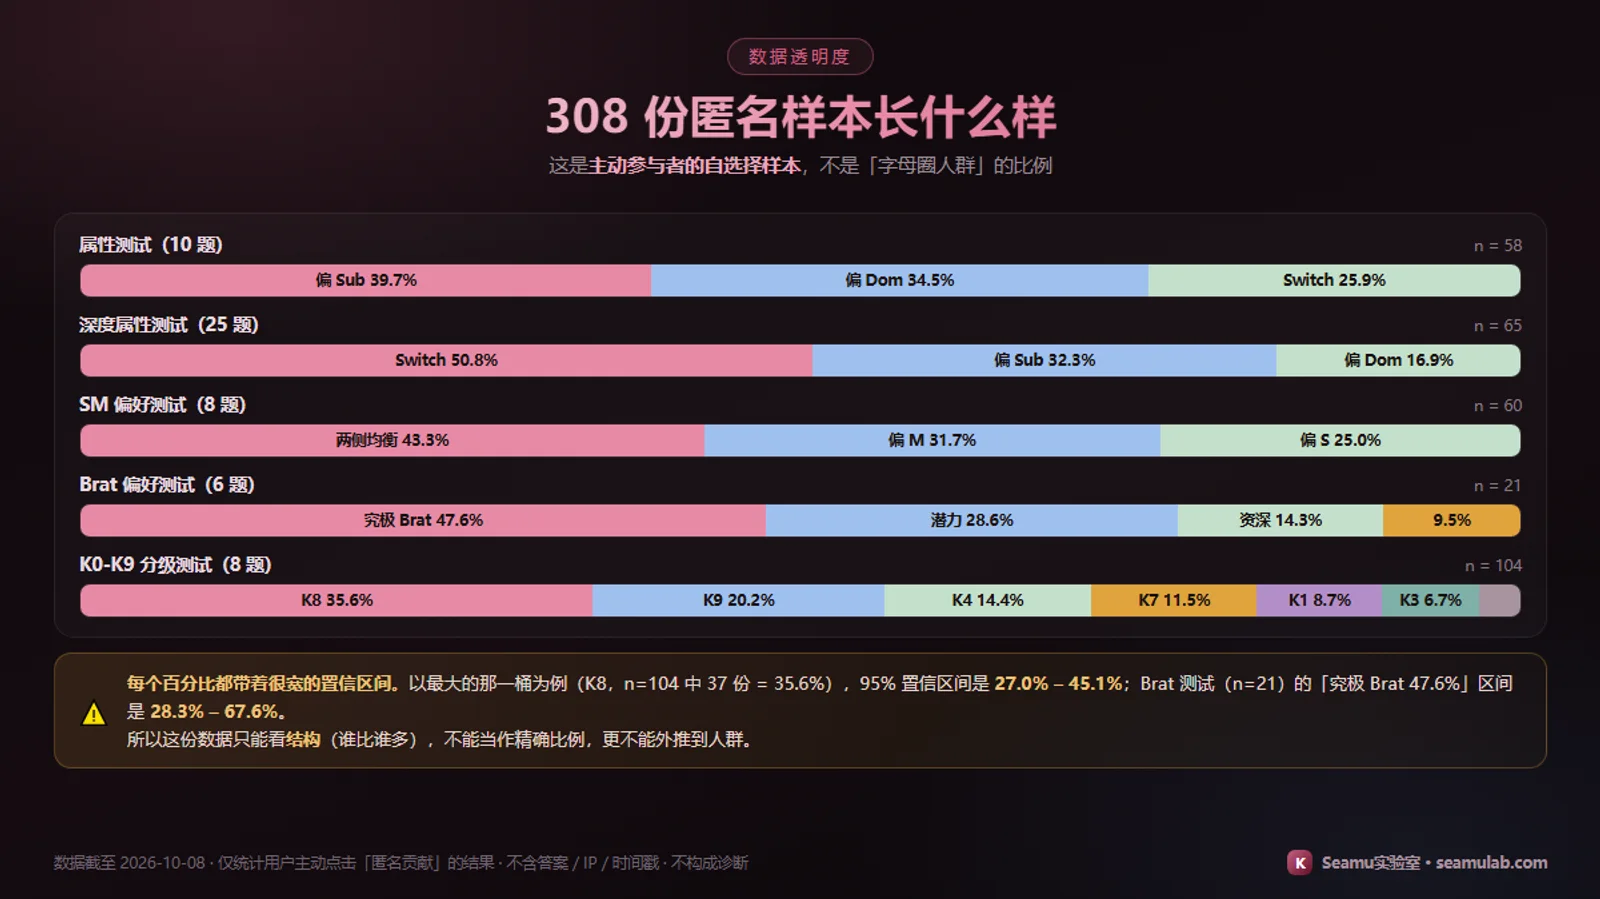
这份报告公开的是我们自己的匿名样本:截至 2026-10-08,共 308 份测试结果。它不是「字母圈人群」的比例,而是「主动参与我们站点、并主动点击了匿名贡献的人」的自选择样本。 所以我们不只放数字,同时放出每个百分比的 95% 置信区间,以及三个我们回答不了的问题——因为在这么小的样本上,说清"不能说什么"比多说三个百分比更重要。
一、先说局限(放在最前面)
任何一份数据报告,最有信息量的部分往往不是结论,而是它对自身边界的说明。这份数据的边界有六条:
- 自选择偏差:只有做完测试、并且愿意点「匿名贡献」的人进入样本。愿意分享的人,很可能比一般使用者更愿意探索、更习惯谈论这类话题。
- 不是配对样本:做过 10 题测试的人和做过 25 题测试的人不是同一批人,我们不能做"同一个人前后变化"的分析(这是隐私设计的必然结果,见第四节)。
- 没有信效度检验:这些测试是自我探索工具,不是心理测量量表,没有做过临床信效度检验(见测试方法论)。
- 样本很小:单个测试的样本量在 21–104 之间。n=21 时,一份答卷就等于 4.8 个百分点。
- 只能看结构,不能看趋势:聚合表只存累计计数,没有历史快照(第六节会展开)。
- 不构成诊断:任何结果都不能用于判断自己或他人"是什么人"。
换句话说:下面这些数字,只能回答"在我站参与者里,各结果是怎么分布的"这一个问题。 换一个问题,它们就都不适用。
二、数据是怎么来的
这一节不是免责声明,而是让上面的数字可被检验:
- 只有主动上报:结果页上有一个「匿名贡献」按钮,你不点,就没有任何数据产生。
- 只上报两个枚举值:测试名 + 结果标签(例如
quick+switch)。不记录任何一道题的答案、不记录分数、不记录 IP、不记录 User-Agent、不记录时间戳、不记录会话标识。 - IP 只在内存里做当日去重:用
哈希(IP + 当天日期)判断"同一天同一来源只计一次",跨天换盐,从不写入数据库,进程重启即清空。所以它既不能追踪个人,也不能跨天关联。 - 结果公开口径:公开页面显示的是聚合计数(
shown_count为空时回落真实值),与数据页读的是同一张表。
代价也很明确:因为不存任何可串联的标识,我们就永远做不了"同一群人的纵向对比"。这是用隐私换来的限制,我们认为值得,但必须写出来。
三、308 份样本的完整分布

属性测试(10 题) — n = 58
| 结果 | 份数 | 占比 | 95% 置信区间 |
|---|---|---|---|
| 偏 Sub(顺从) | 23 | 39.7% | 28.1% – 52.5% |
| 偏 Dom(主导) | 20 | 34.5% | 23.6% – 47.3% |
| Switch(双向) | 15 | 25.9% | 16.3% – 38.4% |
深度属性测试(25 题) — n = 65
| 结果 | 份数 | 占比 | 95% 置信区间 |
|---|---|---|---|
| Switch(双向) | 33 | 50.8% | 38.9% – 62.5% |
| 偏 Sub(顺从) | 21 | 32.3% | 22.2% – 44.4% |
| 偏 Dom(主导) | 11 | 16.9% | 9.7% – 27.8% |
SM 偏好测试(8 题) — n = 60
| 结果 | 份数 | 占比 | 95% 置信区间 |
|---|---|---|---|
| 两侧均衡 | 26 | 43.3% | 31.6% – 55.9% |
| 偏 M(承受) | 19 | 31.7% | 21.3% – 44.2% |
| 偏 S(施加) | 15 | 25.0% | 15.8% – 37.2% |
Brat 偏好测试(6 题) — n = 21
| 结果 | 份数 | 占比 | 95% 置信区间 |
|---|---|---|---|
| 究极 Brat | 10 | 47.6% | 28.3% – 67.6% |
| 潜力 Brat | 6 | 28.6% | 13.8% – 50.0% |
| 资深 Brat | 3 | 14.3% | 5.0% – 34.6% |
| 乖巧顺从型 | 2 | 9.5% | 2.7% – 28.9% |
K0-K9 分级测试(8 题) — n = 104
| 结果 | 份数 | 占比 | 95% 置信区间 |
|---|---|---|---|
| K8 Brat/小恶魔型 | 37 | 35.6% | 27.0% – 45.1% |
| K9 犬系驯服型 | 21 | 20.2% | 13.6% – 28.9% |
| K4 束缚绳缚型 | 15 | 14.4% | 8.9% – 22.4% |
| K7 亲密伴侣型 | 12 | 11.5% | 6.7% – 19.1% |
| K1 贴身服侍型 | 9 | 8.7% | 4.6% – 15.6% |
| K3 恋痛倾向型 | 7 | 6.7% | 3.3% – 13.2% |
| K2 角色服从型 | 3 | 2.9% | 1.0% – 8.1% |
合计 308 份(58 + 65 + 60 + 21 + 104),与数据页的合计一致。
四、能说的三件事
观察 1:「中间态」在两个测试里都是最大的一桶
- 深度属性测试里,Switch 占 50.8%(33/65),是第一大类;
- SM 偏好测试里,两侧均衡占 43.3%(26/60),同样第一。
两个测试都用三个结果,如果结果完全随机,每类应该各占 33.3%。实际的最大桶都明显高于这个数。
这与我们一直强调的立场一致:倾向是一条光谱,中间地带不是"少数派",而是最常见的位置之一。 如果你测出的是"两边都沾",那不是没测准。
观察 2(本次最有意思的一条):题量不同,「中间态」的比例差了一倍
| Switch(双向)占比 | 95% 置信区间 | |
|---|---|---|
| 10 题版属性测试(n=58) | 25.9% | 16.3% – 38.4% |
| 25 题版深度测试(n=65) | 50.8% | 38.9% – 62.5% |
这两个区间不重叠。 也就是说:这个差距不太可能只是抽样波动,题量/维度不同,确实会改变"落在中间"的比例。
⚠️ 但必须同时说清两件事:
- 这是两组不同的人(非配对样本),不是"同一批人做两个版本",所以它不能证明"题目多了就会把人推向中间";
- 更可能的机制是判定方式:25 题版覆盖五个维度、且更容易出现"各维度互相抵消"的组合,于是更多落在中间。
不管机制是哪一种,结论都指向同一件事:测试结果取决于你怎么问、问多少题——它是一张当下的地图,不是一个身份判决。 这也是我们把它叫做"自评工具"而不是"测定"的原因。
观察 3:两个测试的分布极不均匀,值得复核设计
| 测试 | 最大桶 | 最小桶 | 倍数 |
|---|---|---|---|
| K0-K9 分级测试 | K8 35.6% | K2 2.9% | 12.3 倍 |
| Brat 偏好测试 | 究极 Brat 47.6% | 乖巧顺从型 9.5% | 5.0 倍 |
| 深度属性测试 | Switch 50.8% | 偏 Dom 16.9% | 3.0 倍 |
| SM 偏好测试 | 两侧均衡 43.3% | 偏 S 25.0% | 1.7 倍 |
| 属性测试(10 题) | 偏 Sub 39.7% | Switch 25.9% | 1.5 倍 |
K8(Brat/小恶魔型)是 K2(角色服从型)的 12 倍;Brat 测试里"最高一档"占了近一半——后者在分级类测试里是反常识的(通常是中间多、两头少)。
我们的处理方式是不解释、但记录:这两个现象可能来自题目结构与判定阈值、也可能来自传播效应(某个结果更容易被截图分享),但目前的数据无法区分。它是一个信号:这两个测试的题目区分度与阈值值得复核。
五、不能说的:大部分"排名"都不能当真
这是最容易被忽略、也最重要的一节。看两个例子:
例 1:10 题测试里,"偏 Sub 39.7% > 偏 Dom 34.5%" 成立吗?
两者的置信区间是 28.1%–52.5% 与 23.6%–47.3%,大幅重叠。也就是说:真实情况完全可能是"Dom 比 Sub 多",也可能是"两者一样"。我们不能说 Sub 比 Dom 多。
例 2:Brat 测试里"究极 Brat 47.6%"接近一半,能说吗?
n 只有 21,置信区间是 28.3%–67.6%。它可能是"四分之一",也可能是"三分之二"。 这个数字目前只能说明"它不是罕见结果"。
规则:当两个桶的置信区间重叠时,我们只说"它俩看起来差不多",不说"谁比谁多"。按这个标准,上表里只有观察 2 那一组对比(10 题 vs 25 题的 Switch)通过了检验,其余"第一名与第二名"的差距,都还在噪声范围内。
为什么不干脆把 n 做大一点再发?因为这些数字本来就公开在数据页上,随时能看到。与其让大家自己对着裸百分比猜,不如把误差一起摊开。
六、三个我们回答不了的问题
这三个问题都是真实用户会问的,也是我们明确不会含糊过去的:
问题 1:字母圈人群里,Dom / Sub / Switch 各占多少?
回答不了。 因为样本是自选择的:进样本的前提是"来过我们站、做过测试、还愿意点分享"。这个筛选过程会把人群结构整体扭曲,且扭曲的方向我们无法测量。任何拿这份数据当"人群比例"的用法,都是错的。
问题 2:这个比例在变化吗?Switch 是不是变多了?
回答不了——而且这是我们数据模型的一个真实缺口。 当前的聚合表只存"累计计数 + 最近一次更新时间",没有按天或按周的历史快照。所以"变化"这件事目前是不可观测的。我们计划在后续版本补上时间维度(保留每日聚合计数,仍然不含任何个人标识),让趋势第一次变得可见。
问题 3:为什么 K8 最多、K2 最少?
回答不了。 可能的原因至少有三种(题目阈值、描述吸引力、外部传播),现有数据无法区分它们。我们不打算给一个听起来合理但没证据的解释。
七、这些数字该怎么用、怎么不用
可以这样用:
- 了解"在这类自评工具里,中间态往往是最大的一类"——这能减少"我测出来两边都沾,是不是没测准"的焦虑;
- 把结果当作沟通的起点:和伴侣交换彼此的结果,聊"重叠的部分"和"只有一方想试的部分";
- 作为自己探索的参照,而不是结论。
不要这样用:
- ❌ 当成人群比例("戴表字母圈 40% 是 Sub"这类说法,我们不会说,也请别引用我们说);
- ❌ 当成诊断或标签(测出 Sub 不等于你软弱,测出 Dom 也不等于你强势);
- ❌ 用极小样本的桶做判断(Brat 测试的有趣结果不能用"乖巧顺从型只有 9.5%"来证明什么)。
八、下一步
- 补上时间维度:让"分布有没有变化"可观测(仍只保留聚合计数,不含个人标识);
- 复核两个测试的设计:K0-K9 与 Brat 的题目区分度、阈值位置;
- 样本积累到更大规模后重发一次本报告,并把这次的数字并列,让"变化"自己说话;
- 保持透明:本报告的方法、局限、以及每张表的置信区间都写在这里,任何人可以拿着它去核对数据页的实时数字。
一句话总结:308 份样本能告诉我们"在我们这里,中间态是最常见的";它不能告诉我们"人群里谁多谁少"。 我们会继续把数字和它的问题一起公开——因为一个数据页的可信度,不在于它显示了多少百分比,而在于它敢说清哪些话它不能说。
安全声明:本站为 BDSM 安全科普与教育平台,遵循 SSC(安全、理智、知情)原则,仅面向成年人。文中所有测试均为自我探索工具,没有经过临床信效度检验,不构成任何诊断;结果仅供参考,请勿用于评价他人。
常见问题
不代表。这份样本是「在本站做完测试、并主动点击了匿名贡献的人」,属于自选择样本:愿意分享结果的人,可能比一般使用者更愿意探索、也更习惯谈论这类话题。所以它只能描述「参与我们站点的这群人」的结构,不能外推成任何人群的比例。
因为样本很小。以 K0-K9 测试里最大的一桶为例(K8,104 份中有 37 份 = 35.6%),95% 置信区间是 27.0% – 45.1%——真实值可能落在这个范围里的任何位置。不写区间只写「35.6%」,会让人误以为这是一个精确数字,那是误导。
不能,而且是刻意做不到的。我们只记录「某个测试出现了某个结果」这一个计数,不记录任何可以串联两次提交的标识(没有会话 ID、没有设备指纹、IP 只在内存里做当日去重且从不落库)。所以两个测试之间的对比是「两组不同的样本」,不是「同一批人的前后变化」。
因为我们的聚合表只存累计计数与最近一次更新时间,没有按天/按周保存过历史快照。这是当前数据模型的一个真实缺口,本文也把它列进「回答不了」的清单。我们会在后续版本里补上时间维度,让「变化」这件事第一次变得可观测。
我们不知道,也不打算编一个解释。可能的因素有几个——题目结构与判定阈值、各类型描述本身的吸引力、外部传播(某个结果更容易被截图分享)——但目前没有任何数据能区分它们。这种「分布极不均匀」本身就是需要复核测试设计(题目区分度、阈值位置)的信号。
不会。只有你在结果页主动点击「匿名贡献」时,才会上报两个枚举值:测试名与结果标签(例如 quick + switch)。不记录任何一道题的答案、不记录分数、不记录 IP 或 User-Agent、不记录时间戳与会话。IP 仅在内存中以「哈希(IP+当天日期)」的形式用于同日去重,进程重启即清空,从不写入数据库。
📌 关于本文
本文由 Seamu实验室内容团队 整理编写,参考公开性教育、安全实践与亲密关系沟通资料(含 SSC/RACK 原则相关公开文献)。 文章仅面向成年人,内容坚持安全、理智、知情原则,不构成医疗或心理诊断建议。
审核:Seamu实验室内容团队 · 更新于 2026-10-08
📚 参考资料与延伸阅读
- · Wismeijer, A. A. J., & van Assen, M. A. L. M. (2013). Psychological characteristics of BDSM practitioners. Journal of Sexual Medicine.
- · Connolly, P. H. (2006). Psychological functioning of bondage/domination/sado-masochism (BDSM) practitioners. Journal of Psychology & Human Sexuality.
- · Richters, J., et al. (2008). Demographic and psychosocial features of participants in bondage and discipline. Journal of Sexual Medicine.
- · Brown, A., Barker, E. D., & Rahman, Q. (2020). A systematic scoping review of the prevalence, etiological, psychological, and interpersonal factors associated with BDSM. Journal of Sex Research.
- · American Psychiatric Association. DSM-5:Paraphilias 与 Paraphilic Disorders 的区分(BDSM 非病态化的诊断学依据)。
- · 社群共识框架:SSC(Safe, Sane, Consensual)与 RACK(Risk-Aware Consensual Kink)的公开教育与讨论资料。
🧭 你可能还需要
还有疑问?客服在线为你解答
关于本文内容,欢迎扫码添加顾问 1v1 咨询
相关阅读
女王调教是什么意思?女性主导(Femdom)的正确理解与安全边界
女王调教是什么意思?本文讲清字母圈里「女王」这个角色的真实含义:指在权力交换关系中处于主导地位的女性(对应英文 Femdom/Domme)。包含女王与普通 Dom 的区别、Femdom 关系的结构、四个常见误解、必须遵守的安全边界,以及为什么主导方的责任先于权力。
阅读全文 →字母圈里S和M有什么区别?与Dom/Sub的区别一次讲清
S和M有什么区别?本文用「两根轴」讲清最容易混淆的两组概念:S/M 描述的是感官层面(施加还是承受),Dom/Sub 描述的是关系结构(谁掌控、谁交托)。附完整对照表、四种常见组合,以及为什么分清它们对你的沟通和安全很重要。
阅读全文 →M底是什么?如何判断自己有没有M底
M底是什么意思?本文讲清这个圈内常用说法:指一个人骨子里偏向承受、被主导的倾向底色。包括 M 底的具体表现、如何判断自己有没有 M 底、它与 M 属性/Sub 身份的区别,以及发现自己有 M 底之后该怎么安全地认识和探索。
阅读全文 →